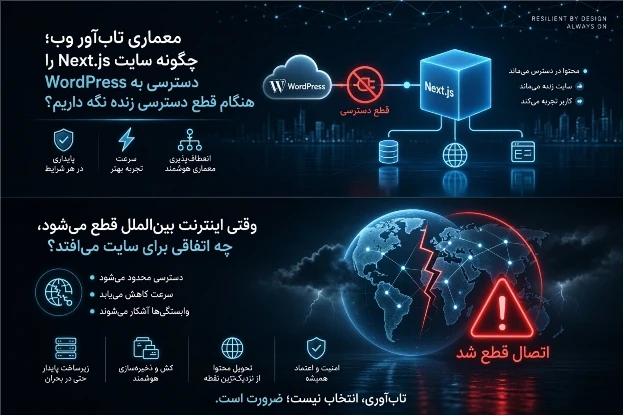
تصور کنید صبح یک مقاله جدید در سایت منتشر کردهاید. سایت بدون مشکل کار میکند، کاربران وارد صفحات مختلف میشوند و موتورهای جستجو نیز ساختار سایت را میشناسند.
اما چند ساعت بعد، شرایط تغییر میکند.
این بار مشکل از سرور، کد، دیتابیس یا حتی خود سایت نیست. ارتباط اینترنت بینالملل دچار اختلال شده و سرویسهایی که خارج از کشور قرار دارند دیگر نمیتوانند به زیرساخت داخل ایران دسترسی داشته باشند.
در چنین شرایطی ممکن است یک سؤال مهم مطرح شود:
اگر WordPress در دسترس نباشد، آیا Frontend سایت هم باید از کار بیفتد؟
از نظر من، پاسخ لزوماً «بله» نیست.
اگر معماری سایت را از ابتدا با در نظر گرفتن سناریوهای شکست طراحی کنیم، میتوانیم کاری کنیم که حتی در صورت از دسترس خارج شدن WordPress، نسخهای از آخرین محتوای معتبر سایت همچنان در اختیار Next.js باشد.
ایدهای که در این مقاله مطرح میکنم بر همین اساس است: Frontend همچنان با Next.js اجرا میشود، اما اگر نتواند محتوای جدید را از WordPress دریافت کند، بهصورت کنترلشده از یک Snapshot ذخیرهشده از محتوا استفاده میکند.
هدف این نیست که نسخه آفلاین جای سایت اصلی را بگیرد. هدف این است که در یک شرایط بحرانی، URLها، ساختار سایت و آخرین نسخه قابل استفاده محتوا تا حد امکان حفظ شوند.
وقتی اینترنت بینالملل قطع میشود، چه اتفاقی برای سایت میافتد؟
برای درک این معماری ابتدا باید یک نکته را روشن کنیم.
در این سناریو، فرض ما این نیست که کاربر ایرانی به اینترنت دسترسی ندارد. مسئله این است که ارتباط با بخشی از زیرساخت جهانی اینترنت ممکن است دچار اختلال شود.
فرض کنید WordPress سایت روی یک سرور داخل ایران قرار دارد و Frontend سایت با Next.js روی زیرساخت دیگری اجرا میشود.
در حالت عادی ارتباط به این شکل است:
User
  │
  ▼
Next.js
  │
  ▼
WordPress API
  │
  ▼
Content
Next.js برای نمایش یک مقاله، صفحه یا اطلاعات دیگر، داده را از WordPress دریافت میکند.
حالا اگر Next.js نتواند به WordPress API دسترسی داشته باشد چه؟
اگر هیچ مکانیزم جایگزینی وجود نداشته باشد، نتیجه میتواند چیزی شبیه این باشد:
Next.js
   │
   ▼
WordPress API
   │
   X
Connection Failed
   │
   ▼
Error / Empty Page / 500
من توصیه میکنم هنگام طراحی معماریهای واقعی، فقط مسیر موفقیت را طراحی نکنیم.
باید همیشه یک سؤال دیگر هم داشته باشیم:
اگر این وابستگی در دسترس نبود، سیستم چه رفتاری باید داشته باشد؟
این سؤال، نقطه شروع معماری تابآور است.

اگر WordPress از دسترس خارج شود، آیا کل سایت باید از کار بیفتد؟
در یک معماری Headless، WordPress الزاماً همان چیزی نیست که کاربر مستقیماً میبیند.
WordPress میتواند نقش CMS یا منبع محتوا را داشته باشد و Next.js مسئول رندر کردن رابط کاربری باشد.
این جداسازی یک مزیت مهم ایجاد میکند.
اگر Frontend و Backend کاملاً به یکدیگر وابسته نباشند، میتوانیم برای زمان خرابی Backend یک مسیر جایگزین طراحی کنیم.
من در چنین شرایطی پیشنهاد میکنم بهجای اینکه Next.js را بهطور کامل وابسته به WordPress کنیم، یک آخرین نسخه معتبر از محتوا نیز در اختیار Frontend قرار دهیم.
این نسخه میتواند به شکل JSON یا Markdown ذخیره شود.
در نتیجه معماری ما از این:
Next.js
   │
   └── WordPress
به این تبدیل میشود:
                 ┌── WordPress API
                 │
Next.js ─────────┤
                 │
                 └── Content Snapshot
در حالت عادی WordPress منبع اصلی اطلاعات است.
اما اگر WordPress پاسخ ندهد، Snapshot وارد عمل میشود.

ایده من: نگهداشتن آخرین نسخه محتوا بهعنوان Safety Net
اینجا به بخش اصلی ایده میرسیم.
فرض کنید آخرین نسخه معتبر سایت شامل ۱۰۰ مقاله و چند صفحه اصلی است.
بهجای اینکه فقط WordPress این محتوا را نگه دارد، میتوانیم یک نسخه ساختاریافته از آن را نیز در پروژه Next.js یا فرآیند Build نگهداری کنیم.
برای مثال:
data/
├── posts/
│   ├── article-1.json
│   ├── article-2.json
│   └── article-3.json
├── pages/
│   ├── about.json
│   └── contact.json
└── manifest.json
این فایلها میتوانند شامل اطلاعاتی مانند:
- عنوان
- slug
- محتوای مقاله
- تاریخ انتشار
- excerpt
- metadata
- دستهبندی
- اطلاعات لازم برای رندر صفحه
باشند.
در این معماری Snapshot قرار نیست جای WordPress را بگیرد.
WordPress همچنان Source of Truth است.
Snapshot فقط یک Safety Net است؛ یعنی آخرین وضعیت معتبر محتوا را برای شرایطی نگه میدارد که منبع اصلی موقتاً قابل دسترسی نیست.
اگر از من بپرسید چرا چنین نسخهای لازم است، پاسخ من ساده است:
چون شکست یک سرویس نباید لزوماً به شکست کل تجربه کاربر منجر شود.
معماری پیشنهادی؛ Next.js همچنان Frontend اصلی باقی میماند
یکی از نکات مهم این راهکار این است که ما سایت دوم یا Frontend دیگری برای زمان قطعی ایجاد نمیکنیم.
Next.js همچنان همان Frontend اصلی است.
در حالت عادی:
Browser
   │
   ▼
Next.js
   │
   ▼
WordPress REST API
   │
   ▼
Live Content
در زمان اختلال:
Browser
   │
   ▼
Next.js
   │
   ▼
WordPress REST API
   │
   X
   │
   ▼
Local Snapshot
   │
   ▼
Cached Content
بنابراین URL نیز تغییر نمیکند.
مثلاً اگر کاربر در حال مشاهده:
/blog/resilient-architecture
باشد، در شرایط عادی همان URL از WordPress محتوا دریافت میکند و در شرایط خطا نیز همان URL توسط Next.js رندر میشود.
ما کاربر را به یک URL دیگر هدایت نمیکنیم.
این موضوع برای معماری و SEO اهمیت زیادی دارد، چون هدف ما تغییر ساختار URL یا ایجاد نسخهای کاملاً متفاوت از سایت نیست.
در حالت عادی، محتوا از WordPress دریافت میشود
فرض کنیم یک تابع برای دریافت مقاله داریم:
async function getPost(slug: string) {
  const response = await fetch(
    `${WORDPRESS_URL}/wp-json/wp/v2/posts?slug=${slug}`
  );

  if (!response.ok) {
    throw new Error("WordPress API failed");
  }

  return response.json();
}
تا زمانی که WordPress در دسترس است، همه چیز طبق روال عادی پیش میرود.
اما معماری ما باید یک مرحله دیگر هم داشته باشد.
وقتی API وردپرس در دسترس نیست، چه اتفاقی میافتد؟
در اینجا مفهوم Fallback وارد میشود.
من پیشنهاد میکنم منطق دریافت داده چیزی شبیه این باشد:
async function getPost(slug: string) {
  try {
    return await getPostFromWordPress(slug);
  } catch (error) {
    console.error("WordPress unavailable:", error);

    return getPostFromSnapshot(slug);
  }
}
این کد ساده است، اما مفهوم معماری را بهخوبی نشان میدهد:
- ابتدا منبع اصلی را امتحان کن.
- اگر پاسخ معتبر دریافت شد، همان را استفاده کن.
- اگر درخواست شکست خورد، به Snapshot مراجعه کن.
- اگر Snapshot وجود داشت، همان محتوا را رندر کن.
- اگر هیچ منبعی وجود نداشت، یک خطای کنترلشده ارائه کن.
این تفاوت مهمی با یک try/catch ساده دارد.
ما در واقع داریم رفتار سیستم هنگام Failure را طراحی میکنیم.
Content Fallback چیست و چگونه کار میکند؟
Fallback یعنی وقتی مسیر اصلی قابل استفاده نیست، سیستم به یک مسیر جایگزین از قبل تعریفشده منتقل شود.
در معماری ما:
Primary Source
WordPress API
      │
      ├── Success ──► Render
      │
      └── Failure
             │
             ▼
       Content Snapshot
             │
        ┌────┴────┐
        │         │
      Found    Not Found
        │         │
        ▼         ▼
      Render   Controlled Error
این نکته مهم است که Fallback نباید بینهایت Retry کند.
اگر API در دسترس نیست، نباید سیستم چندین بار درخواست بفرستد و زمان پاسخ را برای کاربر بالا ببرد.
من توصیه میکنم برای چنین معماریای Timeout، Logging و مدیریت خطا از ابتدا در نظر گرفته شود.
چرا URLهای سایت را تغییر نمیدهیم؟
یکی از اهداف اصلی این معماری حفظ URL است.
فرض کنید صفحهای با این آدرس داریم:
/blog/headless-wordpress
در زمان عادی:
/blog/headless-wordpress
        ↓
Next.js
        ↓
WordPress API
در شرایط اختلال:
/blog/headless-wordpress
        ↓
Next.js
        ↓
WordPress API ❌
        ↓
Snapshot
آدرس همچنان همان است.
ما نمیخواهیم در زمان اختلال کاربر را به:
/backup/blog/headless-wordpress
یا دامنه دیگری منتقل کنیم.
هدف این است که مسئله در لایه داده حل شود، نه در URL.
هدف این معماری در برابر Google چیست؟
اینجا باید بین چند موضوع تفاوت قائل شویم.
هدف من از این معماری این نیست که ادعا کنم با آن میتوان بهطور قطعی جلوی افت رتبه یا هرگونه مشکل Google را گرفت.
هیچ معماریای چنین تضمینی نمیدهد.
در سناریوی مورد بحث، فرض ما این است که هنگام اختلال اینترنت بینالملل، هم کاربر ممکن است دسترسی محدودی داشته باشد و هم Googlebot نتواند مانند شرایط عادی به زیرساخت دسترسی پیدا کند.
بنابراین مسئله اصلی در آن لحظه Google نیست؛ تداوم دسترسی و ثبات معماری سایت است.
من این راهکار را با این هدف پیشنهاد میکنم که:
- URLهای سایت تغییر نکنند.
- ساختار مسیرها ثابت بماند.
- Frontend کاملاً به API وابسته نباشد.
- آخرین نسخه معتبر محتوا در دسترس باشد.
- هنگام بازیابی سرویس، سیستم به حالت عادی برگردد.
- از ایجاد نسخههای پراکنده و URLهای جایگزین غیرضروری جلوگیری شود.
به بیان ساده، ما تلاش میکنیم سایت را از نظر داده در برابر شکست WordPress مقاوم کنیم.
Snapshot چیست و چرا باید از آخرین نسخه محتوا نگهداری کنیم؟
Snapshot در این معماری، تصویری از وضعیت محتوا در یک زمان مشخص است.
برای مثال:
{
"slug": "resilient-architecture",
"title": "معماری تابآور وب",
"content": "...",
"updatedAt": "2026-09-10T18:30:00Z"
}
این فایل میتواند در Repository پروژه نگهداری شود.
اما یک نکته مهم وجود دارد:
GitHub نباید در زمان درخواست کاربر تبدیل به CMS شود.
یعنی این معماری را پیشنهاد نمیکنم:
User
 ↓
Next.js
 ↓
GitHub
 ↓
JSON
چون در این حالت خود GitHub به یک Runtime Dependency تبدیل میشود.
معماری بهتر این است:
WordPress
    │
    ▼
Automation
    │
    ▼
GitHub Repository
    │
    ▼
Build
    │
    ▼
Next.js
    │
    ▼
Bundled Snapshot
GitHub در اینجا نقش Version Control و Build Source را دارد، نه سرویس دادهای که کاربر در هر Request مستقیماً از آن محتوا دریافت کند.
Markdown یا JSON؛ کدام گزینه برای Snapshot مناسبتر است؟
هر دو گزینه قابل استفادهاند.
JSON
برای محتواهای ساختاریافته انتخاب مناسبی است:
posts.json
pages.json
categories.json
مزیت آن این است که دسترسی به فیلدهای مختلف آسان است.
Markdown
اگر سایت بیشتر محتوایی و وبلاگی باشد، Markdown میتواند گزینه جذابی باشد.
مثلاً:
content/
├── articles/
│   ├── resilient-architecture.md
│   ├── nextjs-performance.md
│   └── headless-wordpress.md
Markdown برای نگهداری محتوای متنی خوانایی بسیار خوبی دارد.
در پروژههای مختلف، من انتخاب را بر اساس ساختار داده انجام میدهم.
اگر دادهها ساختاریافته و وابسته به فیلدهای مختلف باشند، JSON انتخاب طبیعیتری است. اگر تمرکز اصلی روی مقالات و محتوای متنی باشد، Markdown نیز میتواند گزینه مناسبی باشد.
GitHub چه نقشی در این معماری دارد؟
GitHub در این معماری میتواند محل نگهداری Snapshot باشد.
مثلاً:
WordPress
    │
    │ Publish / Update
    ▼
Webhook
    │
    ▼
GitHub Actions
    │
    ├── Fetch content
    ├── Generate Snapshot
    ├── Validate
    └── Commit
این روش یک مزیت مهم دارد:
تغییرات محتوا Versioned میشوند.
یعنی اگر Snapshot اشتباه تولید شد، میتوانیم سابقه تغییرات را بررسی کنیم و حتی به نسخه قبلی برگردیم.
بهروزرسانی خودکار Snapshot با Webhook و GitHub Actions
من توصیه میکنم این فرآیند دستی نباشد.
فرض کنید هر بار که مقالهای منتشر میشود، یک Webhook اجرا شود.
چرخه کلی:
Publish Post
     │
     ▼
WordPress
     │
     ▼
Webhook
     │
     ▼
GitHub Actions
     │
     ├── Fetch WordPress API
     ├── Generate JSON/Markdown
     ├── Validate Snapshot
     ├── Commit
     └── Build / Deploy
در این حالت اگر مقاله جدیدی منتشر شود، نسخه Snapshot نیز بهصورت خودکار بهروزرسانی خواهد شد.
البته در یک پیادهسازی واقعی باید امنیت Webhook و Secretها جدی گرفته شود.
من پیشنهاد نمیکنم Tokenهای دسترسی را مستقیماً داخل functions.php یا Repository قرار دهیم.
Secretها باید در محل امن مدیریت شوند.
معماری کامل؛ از انتشار مقاله تا بهروزرسانی نسخه آفلاین
اگر همه اجزا را کنار هم قرار دهیم، معماری تقریباً به این شکل خواهد بود:
                     WordPress
                         │
                  Publish / Update
                         │
                         ▼
                      Webhook
                         │
                         ▼
                  GitHub Actions
                         │
             ┌───────────┴───────────┐
             │                       │
       Fetch Content           Generate Snapshot
             │                       │
             └───────────┬───────────┘
                         ▼
                    Git Repository
                         │
                         ▼
                       Build
                         │
                         ▼
                      Next.js
                         │
             ┌───────────┴───────────┐
             │                       │
       WordPress API            Snapshot
          available             available
             │                       │
             ▼                       ▼
        Live Content            Fallback
این یعنی Snapshot بخشی از چرخه Deployment است و نه یک سرویس مستقل که کاربر مستقیماً با آن ارتباط برقرار کند.
چگونه شکست WordPress API را تشخیص دهیم؟
این بخش از نظر مهندسی بسیار مهم است.
«قطع بودن WordPress» فقط به معنی HTTP 500 نیست.
ممکن است با موارد مختلفی روبهرو شویم:
- Connection Timeout
- DNS Failure
- Connection Refused
- HTTP 500
- HTTP 502
- HTTP 503
- پاسخ نامعتبر
- JSON خراب
- قطع ارتباط در میانه درخواست
بنابراین بهتر است لایه Data Fetching بتواند خطاها را مدیریت کند.
مثلاً:
Request
   │
   ▼
WordPress API
   │
   ├── 200 ───────► Live Data
   │
   ├── 500 ───────► Fallback
   │
   ├── 503 ───────► Fallback
   │
   ├── Timeout ───► Fallback
   │
   └── Invalid ───► Fallback
این همان جایی است که یک راهکار ساده به یک طراحی مهندسی تبدیل میشود.
طراحی مکانیزم بازگشت خودکار به حالت عادی
Fallback نباید یکطرفه باشد.
یعنی اگر WordPress برای مدتی از دسترس خارج شد، بعد از بازگشت سرویس نباید همچنان برای همیشه Snapshot نمایش داده شود.
چرخه مطلوب:
NORMAL
  │
  │ WordPress unavailable
  ▼
FALLBACK
  │
  │ WordPress available again
  ▼
NORMAL
در نتیجه سیستم باید بتواند دوباره منبع اصلی را امتحان کند.
من پیشنهاد میکنم این رفتار بهصورت صریح در معماری تعریف شود:
Primary → Failure → Fallback → Recovery → Primary
این یکی از تفاوتهای مهم بین یک Fallback ساده و یک سیستم واقعاً تابآور است.
چگونه این معماری را بهصورت واقعی تست کنیم؟
به نظر من این بخش نباید از مقاله حذف شود.
اگر قرار است بگوییم سیستم در برابر Failure مقاوم است، باید Failure را عمداً ایجاد و آزمایش کنیم.
به این روش میتوانیم از مفهوم Fault Injection استفاده کنیم.
برای مثال، در محیط تست دسترسی به WordPress را عمداً از بین میبریم.
سناریوی اول:
WordPress API → 200
نتیجه:
Live Content
سناریوی دوم:
WordPress API → Timeout
نتیجه مورد انتظار:
Snapshot
سناریوی سوم:
WordPress API → 503
نتیجه:
Snapshot
سناریوی چهارم:
WordPress API → Invalid Response
نتیجه:
Snapshot
سناریوی پنجم:
WordPress API → Available Again
نتیجه:
Live Content
شبیهسازی Timeout، خطای 500 و قطع دسترسی به API
برای تست میتوانیم چند سناریو را شبیهسازی کنیم.
مثلاً آدرس API را موقتاً به یک Endpoint نامعتبر تغییر دهیم.
یا در محیط Development یک تأخیر مصنوعی ایجاد کنیم:
await new Promise(resolve => setTimeout(resolve, 10000));
و بررسی کنیم آیا Timeout تعریفشده باعث فعال شدن Fallback میشود یا خیر.
همچنین میتوانیم پاسخهای مختلف HTTP را شبیهسازی کنیم:
200 → Live
500 → Fallback
502 → Fallback
503 → Fallback
Timeout → Fallback
اما تست مهمتر این است که بررسی کنیم URL تغییر نمیکند.
برای مثال:
/blog/example
باید قبل و بعد از Failure دقیقاً همان URL باقی بماند.
اگر Snapshot هم در دسترس نباشد چه میشود؟
یک سیستم حرفهای نباید فقط سناریوی «همهچیز درست است» و «WordPress قطع است» داشته باشد.
ممکن است Snapshot هم ناقص یا خراب باشد.
در نتیجه:
WordPress
    │
    X
    ▼
Snapshot
    │
    X
    ▼
Controlled Error
در این شرایط باید یک خطای کنترلشده داشته باشیم.
من توصیه میکنم هیچوقت سیستم را در یک حلقه Retry بینهایت قرار ندهیم.
همچنین Snapshot باید قبل از انتشار یا Deployment اعتبارسنجی شود.
مثلاً:
- JSON معتبر است؟
- slugها وجود دارند؟
- title وجود دارد؟
- محتوای ضروری موجود است؟
- Snapshot خالی نیست؟
- ساختار مورد انتظار رعایت شده است؟
این Validation میتواند در GitHub Actions انجام شود.
محدودیتهای این راهکار؛ نسخه آفلاین قرار نیست جای سایت اصلی را بگیرد
این معماری یک راهحل جادویی نیست.
Snapshot ممکن است آخرین تغییرات WordPress را نداشته باشد.
مثلاً:
WordPress:
Article updated at 12:00

Snapshot:
Last updated at 11:45
در نتیجه اگر در ساعت 12:05 WordPress از دسترس خارج شود، نسخه Snapshot ممکن است 20 دقیقه عقبتر باشد.
این موضوع کاملاً قابل قبول است، چون هدف Snapshot ارائه آخرین نسخه موفق ذخیرهشده است، نه تضمین همگامسازی لحظهای.
همچنین ممکن است تصاویر در شرایط اختلال قابل دسترسی نباشند.
من این مسئله را در طراحی اولیه یک مشکل حیاتی نمیدانم، زیرا هدف اصلی این معماری حفظ:
- URL
- متن
- ساختار صفحه
- عنوان
- محتوای اصلی
- مسیرهای سایت
است.
اگر تصویر در دسترس نباشد اما مقاله و URL همچنان قابل مشاهده باشند، سیستم حداقل میتواند بخش مهمی از اطلاعات را حفظ کند.
آیا این معماری باعث حفظ رتبه گوگل میشود؟
اینجا باید واقعبین باشیم.
خیر، نمیتوان گفت این معماری رتبه Google را تضمین میکند.
رتبهبندی و ایندکس شدن به عوامل بسیار بیشتری وابسته است و در زمان اختلال گسترده شبکه نیز شرایطی خارج از کنترل ما وجود دارد.
اما این معماری یک هدف مشخص دارد:
تا حد امکان URL و ساختار سایت را ثابت نگه دارد و وابستگی Frontend به در دسترس بودن لحظهای CMS را کاهش دهد.
از دید من این تفاوت بسیار مهم است.
ما نمیخواهیم برای هر شرایط بحرانی یک سایت جدید با URLهای جدید ایجاد کنیم.
ما میخواهیم همان سایت، با همان مسیرها، تا جای ممکن بتواند آخرین داده معتبر خود را ارائه کند.
بنابراین اگر از من بپرسید هدف اصلی این معماری چیست، پاسخ من این است:
حفظ تداوم دسترسی و ثبات URLها، نه وعده حفظ قطعی رتبه در Google.
یک نگاه کلی به معماری نهایی
در نهایت معماری ما به این شکل خلاصه میشود:
                         ┌─────────────────┐
                         │    WordPress    │
                         │   Source Data   │
                         └────────┬────────┘
                                  │
                               Webhook
                                  │
                                  ▼
                         ┌─────────────────┐
                         │ GitHub Actions  │
                         └────────┬────────┘
                                  │
                         Generate Snapshot
                                  │
                                  ▼
                         ┌─────────────────┐
                         │ JSON / Markdown │
                         │    Snapshot     │
                         └────────┬────────┘
                                  │
                                Build
                                  │
                                  ▼
                         ┌─────────────────┐
                         │     Next.js     │
                         └────────┬────────┘
                                  │
                    ┌─────────────┴─────────────┐
                    │                           │
             WordPress OK               WordPress Failed
                    │                           │
                    ▼                           ▼
               Live Data                    Snapshot
                    │                           │
                    └─────────────┬─────────────┘
                                  ▼
                              Same URL
این معماری یک اصل ساده اما مهم دارد:
خرابی یک Dependency نباید الزاماً به معنی خرابی کل Application باشد.
جمعبندی؛ تابآوری فقط به معنی زنده ماندن سرور نیست
وقتی درباره پایداری سایت صحبت میکنیم، معمولاً ذهن ما به سمت Uptime، سرور، CDN، Backup و Monitoring میرود.
همه اینها مهم هستند.
اما یک سؤال دیگر هم وجود دارد:
اگر یکی از سرویسهایی که Application برای دریافت اطلاعات به آن وابسته است از دسترس خارج شود، خود Application چه میکند؟
در معماری پیشنهادی من، WordPress همچنان CMS اصلی باقی میماند و Next.js همچنان Frontend اصلی است.
ما فقط یک مسیر جایگزین برای داده ایجاد میکنیم.
در حالت عادی:
Next.js → WordPress → Content
و در شرایط Failure:
Next.js → Snapshot → Content
در نتیجه نه لازم است سایت دیگری ایجاد کنیم و نه لازم است URLهای سایت را تغییر دهیم.
به نظر من، این همان جایی است که مفهوم Resilient Architecture از یک اصطلاح تئوریک به یک تصمیم واقعی در طراحی نرمافزار تبدیل میشود.
من توصیه میکنم هنگام طراحی سیستمهای واقعی، همیشه یک سؤال ساده را در کنار مسیر اصلی قرار دهیم:
اگر این قسمت فردا در دسترس نباشد، سیستم من چه خواهد کرد؟
اگر برای این سؤال پاسخ مشخصی داشته باشیم، بخشی از تابآوری سیستم را از قبل طراحی کردهایم.
اگر از من میپرسید، آیا این معماری برای هر سایتی لازم است؟
خیر.
اگر سایت شما کاملاً وابسته به دادههای لحظهای است، Snapshot ممکن است برای همه بخشها مناسب نباشد.
اگر سایت شما یک فروشگاه آنلاین است، نمایش اطلاعات قدیمی قیمت، موجودی یا سفارش میتواند حتی خطرناک باشد.
اما برای سایتهایی که بخش قابلتوجهی از محتوای آنها ایستا یا کمتغییر است، مانند:
- وبلاگها
- سایتهای شرکتی
- مستندات
- صفحات معرفی خدمات
- مقالات آموزشی
- Portfolioها
این الگو میتواند بسیار کاربردیتر باشد.
در نهایت، من این معماری را نه بهعنوان جایگزین WordPress، بلکه بهعنوان یک لایه مقاوم در برابر شکست CMS میبینم.
چون در معماری نرمافزار، هدف این نیست که هیچوقت چیزی خراب نشود.
هدف این است که وقتی چیزی خراب شد، کل سیستم همراه آن خراب نشود.